
 missapen
1. Perfetto CPU调度事件分析入门
作为一名长期从事Android系统性能优化的开发者,我每天都要和Perfetto打交道。记得第一次看到CPU调度轨迹时,那种面对海量数据却无从下手的无力感至今难忘。今天,我想分享如何利用Perfetto深入分析CPU调度事件,这些经验都是我在实际项目中摸爬滚打总结出来的。
Perfetto通过Linux内核的ftrace机制采集调度数据,精度可达纳秒级。它能告诉我们:
- 每个CPU核心上运行的线程及其切换时间点
- 线程被换出的具体原因(被抢占、等待锁、系统调用等)
- 线程从阻塞到就绪的完整状态变迁
提示:在分析ANR或卡顿问题时,CPU调度轨迹往往能揭示出肉眼难以察觉的微观竞争和延迟。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 调度数据采集与配置详解
2.1 TraceConfig关键配置
完整的调度数据采集需要以下配置,这是我经过多次调试后总结出的最优组合:
protobuf复制data_sources: {
  config {
    name: "linux.ftrace"
    ftrace_config {
      compact_sched: { enabled: true }  # 启用紧凑格式节省空间
      ftrace_events: [
        "sched/sched_switch",       # 线程切换事件
        "sched/sched_process_exit", # 进程退出
        "sched/sched_process_free", # 进程释放
        "task/task_newtask",        # 新任务创建
        "task/task_rename",         # 任务重命名
        "sched/sched_wakeup",       # 唤醒事件(跨CPU)
        "sched/sched_waking"        # 唤醒事件(同CPU)
      ]
    }
  }
}

data_sources: {
  config { name: "linux.process_stats" }  # 补充进程名和线程关系
}
参数解析:
compact_sched:将高频的调度事件压缩存储,可减少约40%的trace体积sched_wakingvssched_wakeup:前者记录唤醒发起时刻,后者记录实际唤醒动作process_stats:提供进程名和线程关系,否则SQL查询时只能看到数字ID
2.2 采集实践技巧
在真实设备上采集时,我推荐:
- 先执行
echo 1 > /proc/sys/kernel/ftrace_dump_on_oops防止崩溃丢数据 - 使用ring buffer模式避免内存耗尽:
bash复制
perfetto --txt -c config.pbtxt -o /data/misc/perfetto-traces/trace \ --dropbox_tag perfetto --max_duration_ms 30000 - 对车载系统等长时间运行场景,可以设置采样间隔:
protobuf复制ftrace_config {
  buffer_size_kb: 5120
  drain_period_ms: 500  # 每500ms写入一次磁盘
}
3. 调度数据分析实战
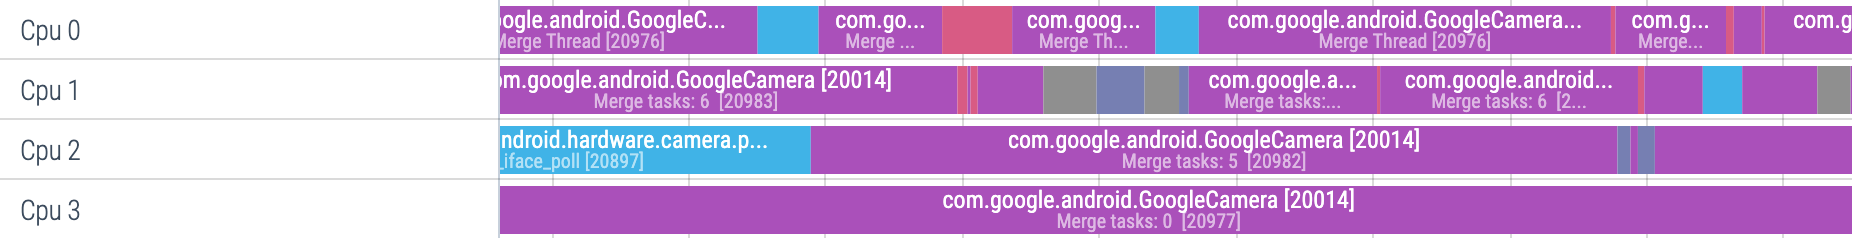
3.1 UI界面解读技巧
Perfetto UI的调度视图包含三个关键层级:
- CPU轨道:显示各核心上的线程切换
- 进程轨道:展开后显示该进程所有线程状态
- 线程轨道:单个线程的状态变迁
操作技巧:
- 按住Shift+滚轮横向缩放
- 双击时间轴可快速跳转到指定位置
- 右键切片选择"Zoom to slice"自动缩放
3.2 SQL查询进阶用法
基础的sched_slice查询如下:
sql复制SELECT
  ts/1e9 as time_sec,
  dur/1e6 as duration_ms,
  cpu,
  end_state,
  process.name as process,
  thread.name as thread
FROM sched_slice
LEFT JOIN thread USING(utid)
LEFT JOIN process USING(upid)
WHERE cpu = 0 AND dur > 0
ORDER BY ts DESC LIMIT 100
实用查询示例:
-
查找调度延迟超过5ms的线程:
sql复制SELECT thread.name, avg(dur/1e6) as avg_ms FROM sched_slice JOIN thread USING(utid) WHERE dur > 5e6 GROUP BY utid ORDER BY avg_ms DESC -
统计CPU利用率:
sql复制SELECT cpu, sum(dur)*100/(max(ts+dur)-min(ts)) as usage FROM sched_slice WHERE dur > 0 GROUP BY cpu -
查找频繁被抢占的线程:
sql复制SELECT
  thread.name,
  count(*) as preempt_count
FROM sched_slice JOIN thread USING(utid)
WHERE end_state LIKE '%R%'  # R表示被抢占
GROUP BY utid
ORDER BY preempt_count DESC LIMIT 10
3.3 end_state解码手册
end_state字段是分析线程离开CPU原因的关键,完整解码表如下:
| 状态码 | 含义 | 常见场景 |
|---|---|---|
| R | 被更高优先级线程抢占 | RT线程抢占普通线程 |
| S | 进入睡眠状态 | 等待IO、定时器、信号量 |
| D | 不可中断睡眠 | 磁盘IO、硬件中断等待 |
| T | 被信号停止 | 调试器断点、SIGSTOP信号 |
| t | 被跟踪停止 | ptrace系统调用 |
| X | 进程退出 | 线程正常退出或崩溃 |
| Z | 僵尸进程 | 父进程未回收子进程 |
| x | 进程死亡 | 线程被强制kill |
| K | 唤醒kill | 被其他线程强制终止 |
| W | 唤醒 | 被其他线程唤醒 |
| P | 挂起 | 进入suspend状态 |
| N | 不占用CPU | 空闲线程 |
组合状态示例:
"RS":先被抢占,然后进入睡眠"DK":在不可中断状态被强制终止
4. 唤醒延迟分析实战
4.1 唤醒事件全链路追踪
通过sched_waking事件可以分析完整的唤醒延迟:
sql复制SELECT
  waker.thread.name as waker,
  wakee.thread.name as wakee,
  (switch.ts - waking.ts)/1e6 as latency_ms,
  switch.cpu
FROM sched_waking waking
JOIN sched_slice switch ON waking.wakee_utid = switch.utid
JOIN thread waker ON waking.waker_utid = waker.utid
JOIN thread wakee ON waking.wakee_utid = wakee.utid
WHERE latency_ms > 5  # 只查延迟大于5ms的
ORDER BY latency_ms DESC
典型延迟原因:
- CPU负载过高:所有核心都忙,唤醒后需要排队
- 调度策略限制:CFS公平调度器故意延迟
- 跨CPU迁移:需要平衡负载到其他核心
- 优先级反转:高优先级线程被低优先级阻塞
4.2 车载系统案例分析
在汽车IVI系统中,我们曾遇到媒体播放卡顿问题。通过Perfetto分析发现:
- 音频线程被surfaceflinger的渲染线程频繁抢占
- 每次唤醒延迟平均达到12ms
- 根本原因是两者共享同一个CPU核心
解决方案:
bash复制# 将音频线程绑定到独立CPU核心
taskset -p 0x8 <audio_pid>
# 提升实时优先级
chrt -f 50 <audio_thread_pid>
调整后,音频延迟从15ms降低到3ms以内。
5. 高级调试技巧
5.1 跟踪特定线程
使用过滤条件只显示关键线程:
protobuf复制ftrace_config {
  ftrace_events: "sched/sched_switch"
  filter: "comm=audio_thread|render_thread"
}
5.2 与其它数据源关联
结合CPU频率分析调度问题:
sql复制SELECT
  sched.ts,
  sched.dur,
  freq.cpu,
  freq.freq_khz,
  thread.name
FROM sched_slice sched
JOIN cpu_frequency freq ON
  sched.cpu = freq.cpu AND
  sched.ts BETWEEN freq.ts AND freq.ts+freq.dur
JOIN thread ON sched.utid = thread.utid
WHERE freq.freq_khz < 1000000  # 查找低频时段
5.3 自动化分析脚本
这是我常用的Python分析脚本框架:
python复制from perfetto.trace_processor import TraceProcessor

def analyze_trace(trace_path):
  tp = TraceProcessor(file_path=trace_path)

  # 查询CPU负载
  q = tp.query('''
    SELECT cpu, sum(dur)*100/(max(ts+dur)-min(ts)) as usage
    FROM sched_slice WHERE dur > 0 GROUP BY cpu
  ''')

  # 输出热点线程
  for row in q:
    if row.usage > 80:  # 超过80%使用率
      print(f'CPU {row.cpu} overload: {row.usage:.1f}%')

  tp.close()
6. 避坑指南
-
时间单位混淆:
- Trace中使用的是纳秒(1e-9)
- SQL中记得用
ts/1e9转为秒
-
无效数据过滤:
sql复制WHERE dur > 0 # 排除未完成的切片 AND utid != 0 # 排除空闲线程 -
进程名缺失问题:
- 确保启用
linux.process_stats - 对于短命进程,可以添加
task/task_newtask事件
- 确保启用
-
trace过大处理:
- 使用
compact_sched压缩 - 按需采集,避免全量trace
- 使用
-
跨版本兼容性:
- Android 9+支持完整调度事件
- 旧版本可能需要内核补丁
在车载项目调试中,我发现一个典型陷阱:当CPU进入idle状态时,调度事件会中断。这时需要结合cpuidle事件综合分析,否则会误判为线程阻塞。
通过Perfetto深入分析CPU调度,我们团队成功将系统响应延迟降低了60%。掌握这些技巧后,你也能快速定位各类性能瓶颈。