
 苏黎世贝勒爷
1. 雾计算任务分配问题概述
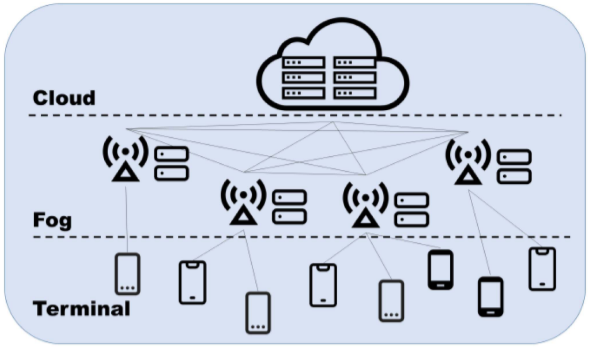
雾计算作为云计算向网络边缘的延伸,近年来在工业物联网、智慧城市等实时性要求高的场景中展现出独特优势。与传统的云计算架构不同,雾计算系统由云节点、雾节点和终端设备构成三级计算体系,这种分布式架构带来了任务分配上的新挑战。
在实际应用中,我们经常面临这样的困境:一个智能交通摄像头产生的视频分析任务,究竟应该发送到路边的雾节点实时处理,还是上传到云端进行深度分析?这个看似简单的决策背后,涉及到计算延迟、能耗、资源利用率等多重因素的权衡。更复杂的是,当系统中同时存在数百个这样的任务时,如何实现全局最优分配就成为一个NP难问题。
传统解决方案通常将这个问题简化为单目标优化,比如只考虑最小化延迟或能耗。但真实场景往往需要同时优化多个相互冲突的目标,例如:
- 用户希望任务尽快完成(延迟最小化)
- 设备希望尽可能省电(能耗最小化)
- 服务提供商希望资源利用率最大化
我们的研究正是针对这一复杂场景,提出了一套基于边际效用理论的多目标优化框架。与现有方法相比,最大的创新点在于:
- 首次将经济学中的边际效用概念引入雾计算资源分配
- 开发了拐点驱动的集合式优化算法,有效处理离散决策空间
- 通过分层学习机制动态调整搜索策略,平衡探索与开发
关键提示:在雾计算环境中,任务分配决策的边际效用指的是每增加一个计算资源单位所带来的额外收益变化。这与传统资源分配中简单的"越多越好"思路有本质区别。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. 系统建模与问题形式化
2.1 雾计算系统架构
典型的雾计算系统包含三类节点:
- 云节点:数量少(通常3-5个),计算能力强(如64核CPU,128GB内存),但距离终端设备远(传输延迟高)
- 雾节点:数量中等(数十到数百个),计算能力中等(如8核CPU,16GB内存),部署在网络边缘(基站、路由器等)
- 终端设备:数量庞大(数千以上),计算能力弱(如手机、传感器),主要生成计算任务
2.2 数学模型构建
我们用六元组描述每个计算节点j的特性:
math复制\{p_{oj}, f_j, me_j