
 张瑞15129378030
1. 国产AI编程助手实战测评:火山方舟Coding Plan深度体验
作为一名长期关注AI编程助手的开发者,最近我系统测试了火山方舟平台的Coding Plan功能(以下简称"方包")。这个号称集成了多个国产顶级模型的编程助手,在实际React项目开发中的表现可谓"惊喜"与"惊吓"并存。下面我将完整还原测试过程,并分享对当前国产AI编程助手的观察与思考。
1.1 测试环境与基准设定
测试项目选择了一个经典的前端开发场景:构建个人博客系统。具体要求包括:
- 使用React框架
- 实现完整的功能模块
- 具备专业级的UI/UX设计
- 代码可立即运行
这个测试案例的价值在于:
- 复杂度适中:既不是简单的demo,也不是企业级项目
- 评估维度丰富:涵盖代码质量、工程能力、设计水平等多个方面
- 可对比性强:此前已用其他AI助手完成过相同任务
测试采用对比方法:
- 先使用Auto模式(平台智能调度模型)
- 再单独测试各主流模型(Doubao、Kimi、GLM、DeepSeek)
- 最后引入Claude和Codex作为参照组
提示:所有测试均在同一台M1 MacBook Pro(16GB内存)上进行,网络环境稳定,排除了硬件因素干扰。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. Auto模式下的"魔幻"体验
2.1 第一次尝试:40分钟换一个"点"
启动Auto模式后,方包的表现堪称行为艺术:
- 计划阶段:生成的开发计划相当专业,与Claude 4.5 Opus水平接近
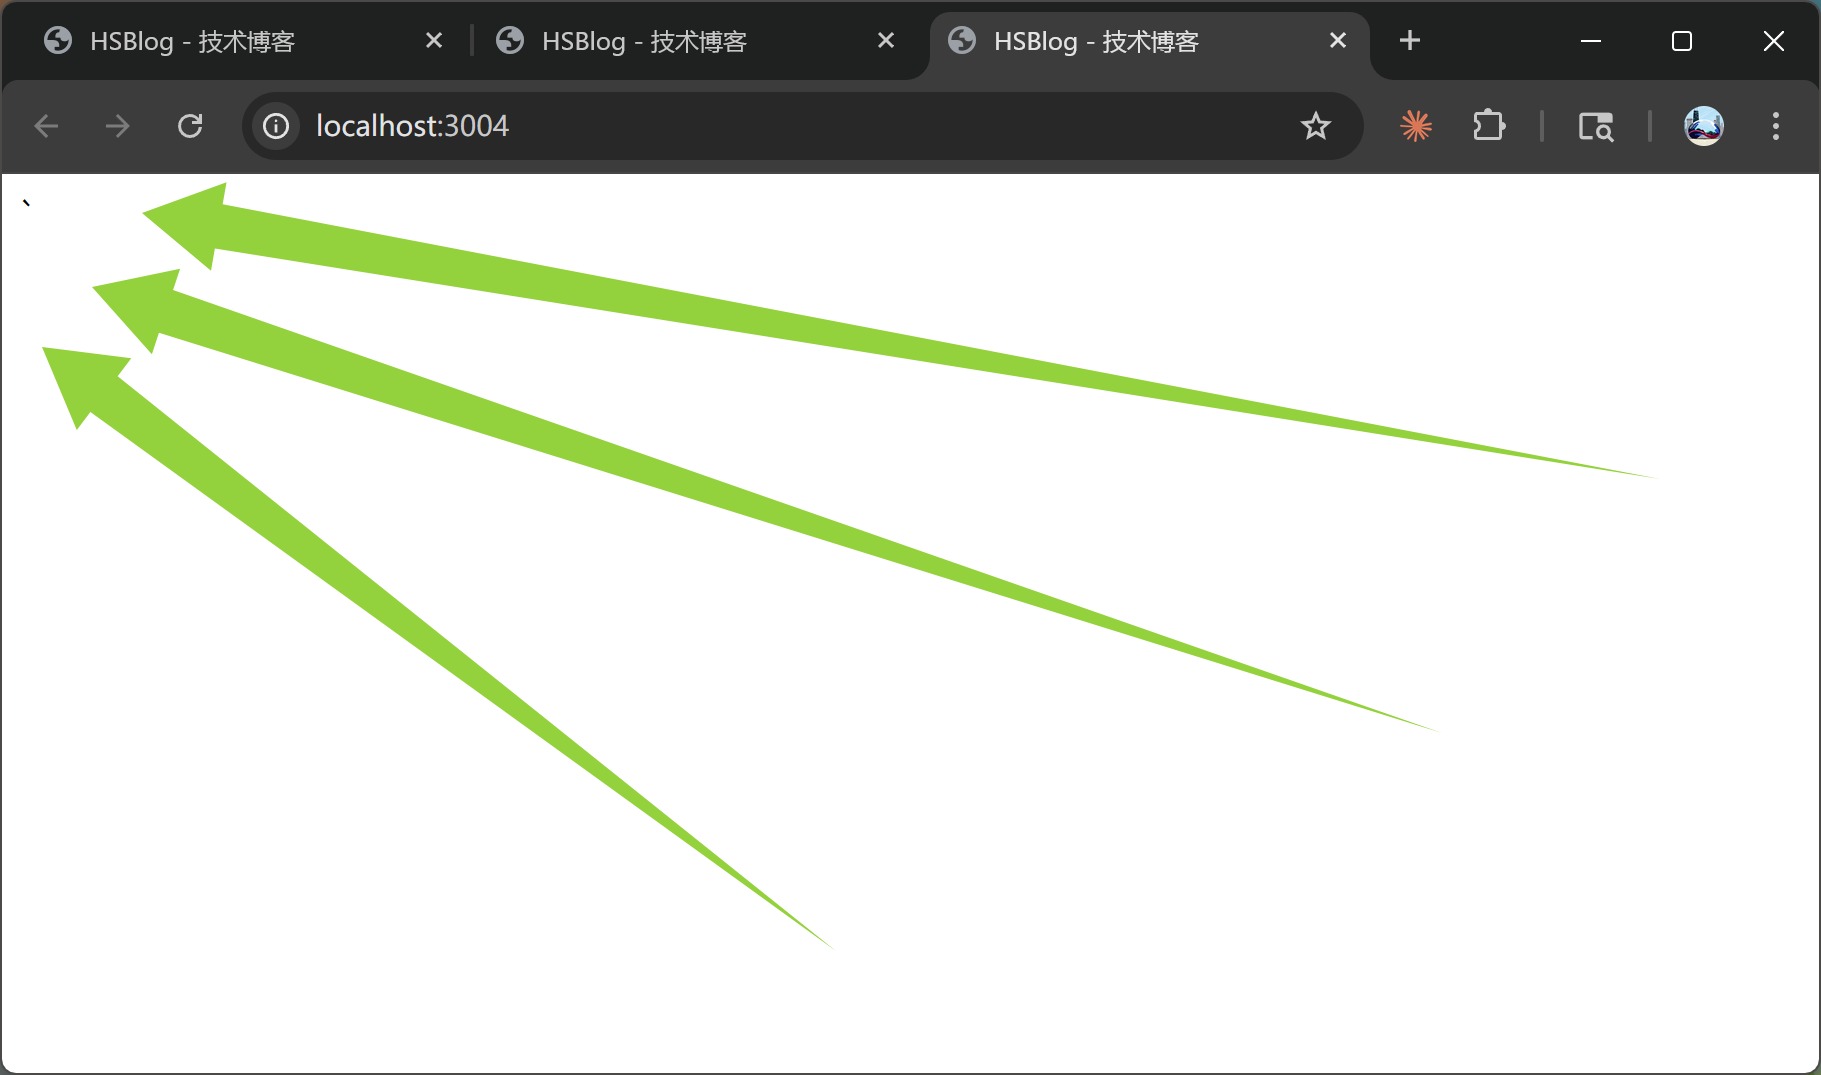
- 执行阶段:从3000端口一直尝试到3004端口,反复报错
- 最终产出:39分33秒后,成功运行出一个仅显示"`"字符的页面
2.2 问题诊断与二次测试
第二次测试中观察到更典型的错误模式:
- 代码生成后立即报错
- 进入"修改-报错-再修改"的死循环
- 最终消耗81%的API配额才勉强运行
关键问题包括:
- 端口冲突处理逻辑缺陷
- 依赖安装顺序错误
- 样式文件引用路径问题
- 缺乏有效的错误恢复机制
bash复制# 典型的端口冲突循环
Port 5173 is in use, trying another one...
Port 5174 is in use, trying another one...
Port 5175 is in use, trying another one...
3. 单模型专项测试结果
3.1 各模型表现对比
| 模型 | 成功启动 | 耗时 | UI质量 | 主要问题 |
|---|---|---|---|---|
| Doubao | 是 | 25分钟 | 中等 | 基础功能完整但设计普通 |
| Kimi | 是 | 32分钟 | 较差 | CSS加载异常,界面丑陋 |
| DeepSeek 3.2 | 否 | 14分钟 | - | 项目初始化失败,删除文件 |
| GLM 4.7 | 是 | 48分钟 | 良好 | 消耗81%配额,多次报错 |
3.2 GLM 4.7的典型问题分析
GLM的表现最具戏剧性:
- 开发阶段:持续报错但声称"一切正常"
- 调试方式:机械式地更换端口号
- 最终产出:经过多次人工干预后才正常运行

注意:同样的GLM 4.7在智谱官方平台表现更好,怀疑是火山方舟的接口适配问题。
4. 问题修复与质量评估
4.1 Claude与Codex的"会诊"结果
引入两位"老师傅"后发现了关键问题:
- 组件生命周期管理错误
- 路由配置冲突
- 样式作用域污染
- 异步加载时序问题
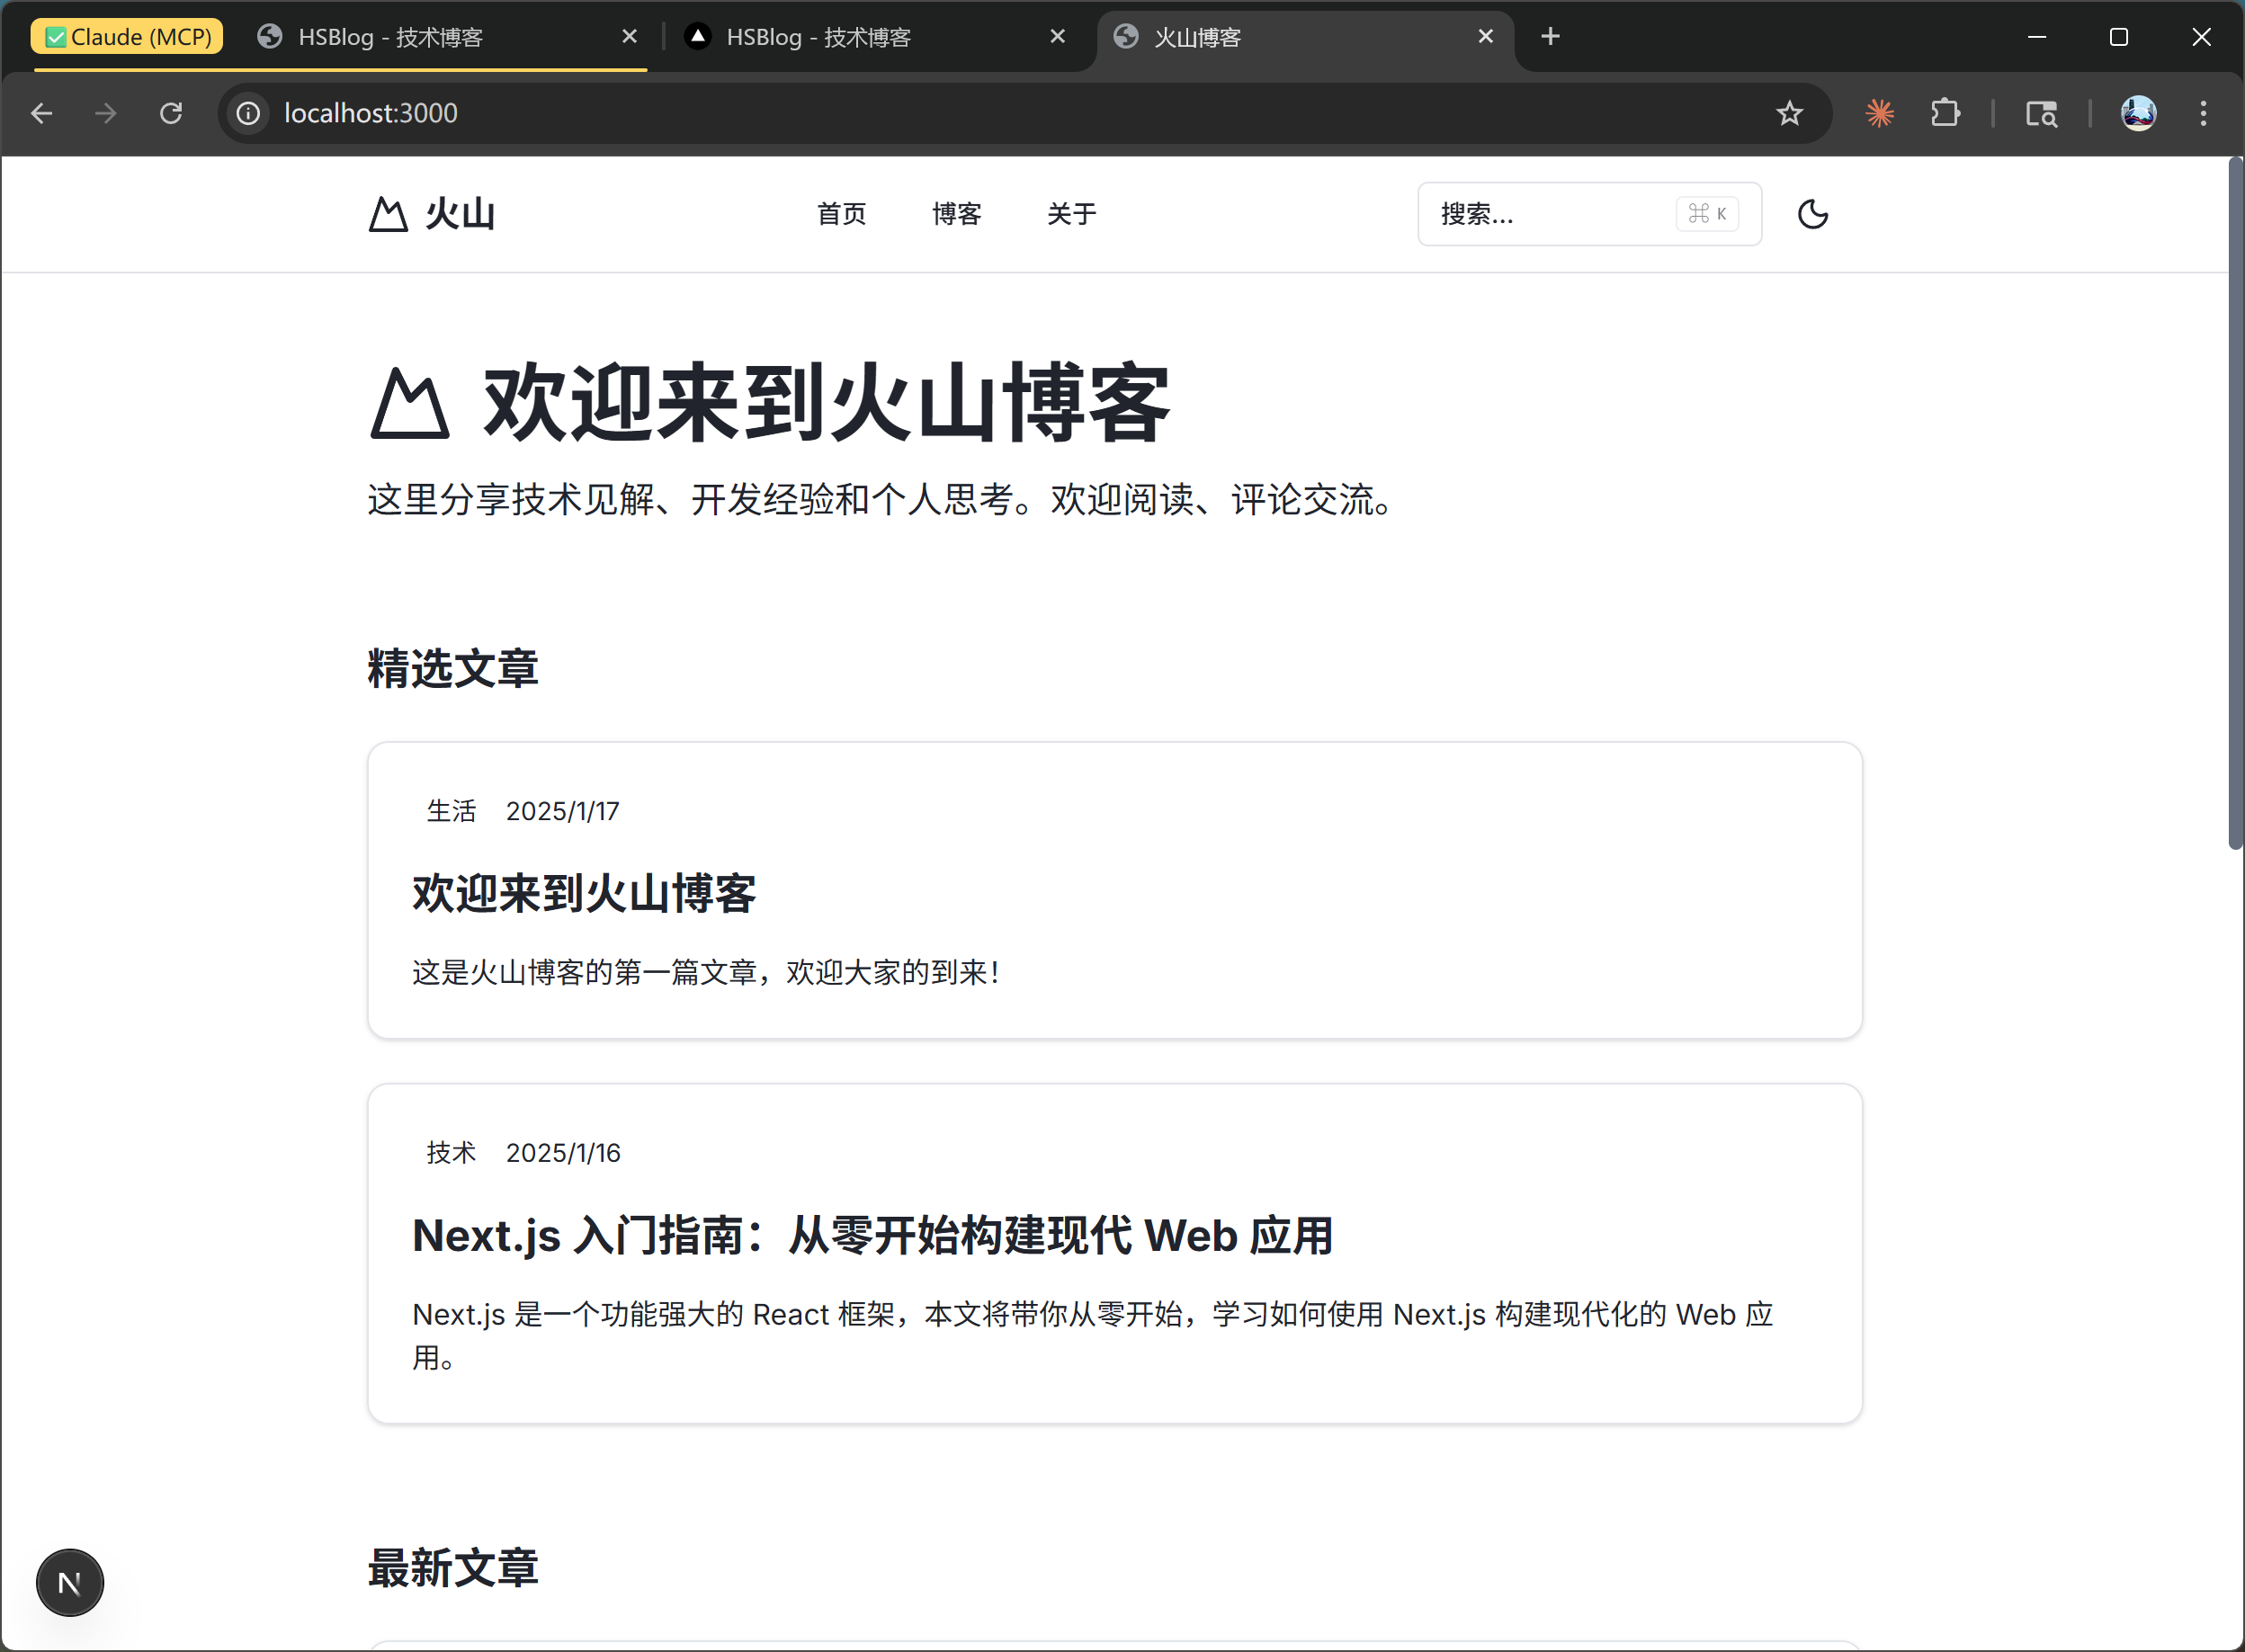
修复后的项目展现出意外的高质量:
- 自定义火山logo设计
- 完善的响应式布局
- 流畅的交互动画
- 完整的文章CRUD功能
4.2 能力矛盾现象解析
这种"代码跑不起来但设计很好"的矛盾源于:
- 优势方面:
- 创意设计能力强
- 功能规划合理
- 文档撰写规范
- 劣势方面:
- 工程实现能力弱
- 错误处理机制缺失
- 缺乏debug能力
5. 深度问题分析与改进建议
5.1 当前主要瓶颈
-
工程能力不足
- 缺乏真实项目经验
- 不熟悉常见开发陷阱
- 调试能力几乎为零
-
资源调度低效
- Auto模式决策机制不透明
- 错误重试策略不合理
- 配额消耗控制不佳
-
开发流程缺陷
- 缺少代码审查环节
- 缺乏自动化测试
- 版本管理混乱
5.2 实用改进方案
对于平台方:
- 建立代码质量检查中间层
- 优化模型调度算法
- 增加开发过程监控
对于开发者:
- 拆解任务为更小的单元
- 设置阶段性检查点
- 准备备用调试方案
6. 国产AI编程助手发展观察
从这次测试可以看出当前国产模型的典型特征:
-
创意设计能力:已达到实用水平
- 界面设计有独特风格
- 交互逻辑合理
- 文档撰写规范
-
工程实现能力:仍需大幅提升
- 基础编码错误频出
- 缺乏debug思维
- 项目经验不足
-
使用策略建议:
- 适合创意设计阶段
- 需要人工审核代码
- 建议与成熟模型配合使用
这次测试最深刻的体会是:AI编程助手就像团队中的新人,既需要给予发挥空间,也要建立有效的质量管控机制。国产模型在创意方面已经展现出独特价值,但在工程严谨性上还需要向Claude、Codex等"老师傅"多学习。