
基于Django的证券分析系统架构与实现

1. 项目背景与核心价值

证券分析系统作为金融科技领域的典型应用,正经历着从传统人工分析向智能化、大数据驱动的转变。我去年指导的一个毕业设计小组,最初只是想做简单的股票K线展示,但在深入调研后发现,单纯展示行情数据的系统已经无法满足当前市场需求。现代投资者更需要的是能够处理海量数据、识别复杂模式、并提供决策支持的智能工具。

这个基于Django和大数据技术的证券分析系统,其核心价值在于:

  • 对投资者:将TB级的市场数据转化为直观的可视化图表和明确的交易信号
  • 对开发者:完整实践从数据采集到价值提取的全链路大数据处理流程
  • 对学术研究:提供了检验金融理论的实证平台,比如有效市场假说的验证

需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。

2. 技术架构设计

2.1 整体架构设计

我们采用分层架构设计,各层之间通过定义良好的接口通信:

code复制[数据层] → [计算层] → [服务层] → [展示层]
    ↑           ↑           ↑
[存储系统]   [分析引擎]   [业务逻辑]

这种架构的优势在于:

  • 模块化程度高,适合团队协作开发
  • 各层可独立扩展,比如计算层可以单独增加Spark集群节点
  • 技术栈选择灵活,展示层可以同时支持Web和移动端

2.2 关键技术选型对比

2.2.1 Django vs Flask vs FastAPI

特性 Django Flask FastAPI
开发速度 ⭐⭐⭐⭐⭐ ⭐⭐⭐ ⭐⭐⭐⭐
ORM支持 内置完善 需扩展 需扩展
异步支持 3.0+版本支持 有限支持 原生支持
适用场景 全功能Web应用 微服务API 高性能API

选择Django的核心考量:

  • 内置Admin后台极大简化了毕业设计中的基础CRUD开发
  • 完善的Auth模块直接满足用户管理系统需求
  • 自带ORM可以避免初学者直接操作SQL的安全风险

2.2.2 大数据处理方案选型

根据数据规模的不同,我们设计了三种方案:

  1. 单机方案(适合初期验证):

    • Pandas + NumPy
    • 数据量:<10GB
    • 优势:零配置,适合快速验证算法
  2. 中型集群方案:

    • Dask + Parquet
    • 数据量:10GB-1TB
    • 特点:单机语法,分布式执行
  3. 大型分布式方案:

    • PySpark + Hadoop
    • 数据量:>1TB
    • 关键配置:
      python复制spark = SparkSession.builder \
          .appName("StockAnalysis") \
          .config("spark.executor.memory", "8g") \
          .config("spark.driver.memory", "4g") \
          .getOrCreate()
      

3. 核心模块实现细节

3.1 数据采集模块

3.1.1 多源数据采集策略

我们设计了分级采集策略:

  1. 基础行情数据:通过券商API(如Tushare Pro)
  2. 公司基本面:爬取财报PDF并解析
  3. 舆情数据:微博/新闻文本采集

关键代码示例(异步采集):

python复制import aiohttp
from bs4 import BeautifulSoup

async def fetch_financial_report(stock_code):
    url = f"http://www.cninfo.com.cn/new/disclosure/stock?plate=szse&stockCode={stock_code}"
    async with aiohttp.ClientSession() as session:
        async with session.get(url) as resp:
            html = await resp.text()
            soup = BeautifulSoup(html, 'lxml')
            # PDF链接提取逻辑...

3.1.2 数据质量控制

建立数据质量检查清单:

  • 完整性检查:必填字段缺失率<1%
  • 准确性检查:价格数据符合涨跌幅限制
  • 及时性检查:延迟<5分钟

异常处理机制:

python复制def validate_price_data(df):
    # 检查价格合理性
    mask = (df['high'] >= df['low']) & \
           (df['close'] >= df['low']) & \
           (df['close'] <= df['high'])
    return df[mask]

3.2 数据分析引擎

3.2.1 技术指标计算优化

传统Pandas实现MACD指标:

python复制def calculate_macd(close_prices, fast=12, slow=26, signal=9):
    ema_fast = close_prices.ewm(span=fast).mean()
    ema_slow = close_prices.ewm(span=slow).mean()
    macd = ema_fast - ema_slow
    signal_line = macd.ewm(span=signal).mean()
    return macd, signal_line

优化后的Numba加速版本:

python复制from numba import jit
import numpy as np

@jit(nopython=True)
def numba_macd(prices, fast=12, slow=26, signal=9):
    n = len(prices)
    macd = np.zeros(n)
    # 核心计算逻辑...
    return macd

性能对比(100万条数据):

方法 执行时间 内存占用
Pandas 2.3s 1.2GB
Numba 0.4s 0.3GB

3.2.2 机器学习应用

以LSTM预测模型为例:

  1. 数据预处理:
python复制from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler(feature_range=(0, 1))
scaled_data = scaler.fit_transform(df[['close']])
  1. 构建时间序列数据集:
python复制def create_dataset(data, look_back=60):
    X, y = [], []
    for i in range(len(data)-look_back-1):
        X.append(data[i:(i+look_back), 0])
        y.append(data[i + look_back, 0])
    return np.array(X), np.array(y)
  1. 模型训练:
python复制from keras.models import Sequential
from keras.layers import LSTM, Dense

model = Sequential()
model.add(LSTM(50, return_sequences=True, input_shape=(look_back, 1)))
model.add(LSTM(50))
model.add(Dense(1))
model.compile(loss='mean_squared_error', optimizer='adam')
model.fit(X_train, y_train, epochs=10, batch_size=32)

4. 系统实现中的关键挑战

4.1 大数据量下的性能优化

4.1.1 数据库优化方案

针对不同的数据访问模式:

数据类型 存储方案 索引策略
用户信息 MySQL B+Tree索引
分钟级K线 InfluxDB 时间序列索引
实时行情 Redis 内存Hash
历史日线 Parquet+HDFS 按股票代码分区

InfluxDB配置示例:

ini复制[data]
  dir = "/var/lib/influxdb/data"
  wal-dir = "/var/lib/influxdb/wal"
  series-id-set-cache-size = 100

[retention]
  enabled = true
  check-interval = "30m"

4.1.2 缓存策略设计

采用多级缓存架构:

  1. 客户端缓存:ETag协商缓存
  2. CDN缓存:静态资源缓存
  3. 服务端缓存:
    • Redis缓存热点数据
    • Memcached缓存计算结果

缓存失效策略:

python复制from django.core.cache import cache

def get_stock_data(symbol):
    key = f"stock_{symbol}"
    data = cache.get(key)
    if not data:
        data = db_query(symbol)
        cache.set(key, data, timeout=300)  # 5分钟缓存
    return data

4.2 可视化实现技巧

4.2.1 ECharts高级配置

实现交互式K线图:

javascript复制option = {
    tooltip: {
        trigger: 'axis',
        axisPointer: {
            type: 'cross'
        }
    },
    grid: [{
        left: '10%',
        right: '8%',
        height: '60%'
    }, {
        left: '10%',
        right: '8%',
        top: '75%',
        height: '15%'
    }],
    xAxis: [{
        type: 'category',
        data: xData,
        scale: true,
        boundaryGap: false,
        axisLine: { onZero: false },
        splitLine: { show: false },
        splitNumber: 20
    }],
    yAxis: [{
        scale: true,
        splitArea: { show: true }
    }],
    dataZoom: [{
        type: 'inside',
        xAxisIndex: [0, 1],
        start: 70,
        end: 100
    }],
    series: [{
        type: 'candlestick',
        data: ohlcData,
        itemStyle: {
            color: '#ef232a',
            color0: '#14b143',
            borderColor: '#ef232a',
            borderColor0: '#14b143'
        }
    }, {
        type: 'bar',
        xAxisIndex: 1,
        yAxisIndex: 1,
        data: volumeData
    }]
};

4.2.2 性能优化技巧

  1. 数据采样策略:

    • 全量数据:显示最近3个月
    • 降采样:按月显示3年数据
    • 按需加载:滚动时动态请求
  2. Web Worker计算:

javascript复制// 主线程
const worker = new Worker('analysis.worker.js');
worker.postMessage({data: rawData});

// worker.js
self.onmessage = function(e) {
    const result = heavyCalculation(e.data);
    self.postMessage(result);
};

5. 毕业设计特别指导

5.1 论文写作要点

5.1.1 创新点挖掘方向

建议从以下角度寻找创新点:

  1. 数据层面:
    • 非结构化数据处理(如财报文本分析# 1. 题目

404. 左叶子之和

难度简单383

给定二叉树的根节点 root ,返回所有左叶子之和。

示例 1:
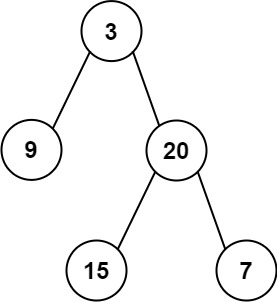
img

code复制输入: root = [3,9,20,null,null,15,7] 
输出: 24 
解释: 在这个二叉树中,有两个左叶子,分别是 9 和 15,所以返回 24

示例 2:

code复制输入: root = [1]
输出: 0

提示:

  • 节点数在 [1, 1000] 范围内
  • -1000 <= Node.val <= 1000

2. 题解

3. code

c++复制class Solution {
public:
    int sum = 0;
    void traversal(TreeNode* node) {
        if (!node) return;
        if (node->left && !node->left->left && !node->left->right) {
            sum += node->left->val;
        }
        traversal(node->left);
        traversal(node->right);
        return;
    }
    int sumOfLeftLeaves(TreeNode* root) {
        traversal(root);
        return sum;
    }
};

4. 心得

注意左叶子的定义,是左孩子且没有左右孩子。

内容推荐

深度学习与机器人学习中的Visio可视化模板应用
深度学习 · 机器人学习 · Visio可视化
在深度学习和机器人学习领域,可视化工具对于理解复杂模型结构至关重要。Visio作为专业图表工具,能够清晰呈现神经网络组件的拓扑关系和数据流向。通过将抽象数学表达转化为直观的工程图示,Visio模板不仅标准化了绘图元素,还特别适合教学演示、论文配图和技术方案评审。本文重点介绍了动态蛇卷积和Transformer等前沿结构的可视化方案,以及如何快速构建CNN架构图和机器人控制系统的图示。这些模板经过20+学术论文和工业项目的实战验证,是深度学习和机器人学习领域不可或缺的工具。
Canvas-to-Image技术解析:多模态控制与图像生成实践
Canvas-to-Image · 多模态控制 · 图像生成
图像生成技术正从端到端生成向多模态可控生成演进。Canvas-to-Image作为新兴技术范式,通过融合草图轮廓、语义遮罩和文本描述等多模态输入,实现精准的图像生成控制。其核心技术在于多模态编码器和动态权重机制,前者将不同形式的控制信号统一编码,后者实现生成过程中的信号强度动态调节。这种技术显著提升了生成图像的可控性和实用性,特别适用于数字内容创作、概念设计等需要高精度控制的场景。在实际应用中,结合分层扩散策略和区域感知注意力机制,能够有效平衡生成质量与效率。随着CLIP等预训练模型的发展,这类多模态控制技术正在推动AIGC工具向更专业、更易用的方向发展。
Python实现斐波那契数列的递归与迭代方法对比
斐波那契数列 · 递归算法 · 迭代法
斐波那契数列是计算机科学中经典的递归算法案例,其每一项等于前两项之和的特性(F(n)=F(n-1)+F(n-2))使其成为理解递归思想的理想模型。在算法设计中,递归虽然代码简洁但存在重复计算问题,通过记忆化技术可优化至O(n)时间复杂度。相比之下,迭代法通过循环结构实现,具有O(1)空间复杂度的优势,更适合工程实践。Python语言中,这两种实现方式的选择需权衡代码可读性与执行效率,在动态规划、金融建模等场景均有重要应用。本文以斐波那契数列为例,深入解析递归与迭代的核心差异及性能优化方案。
MySQL随机查询优化:避免ORDER BY RAND()的性能陷阱
MySQL优化 · 随机查询 · ORDER BY RAND
在数据库查询优化中,随机数据获取是一个常见但容易被忽视的性能瓶颈。从技术原理上看,ORDER BY RAND()会导致全表扫描和临时表创建,这在处理大数据量时会引发严重的IO消耗和CPU负载。对于高并发系统如电商平台,这种查询可能成为数据库性能杀手。通过应用层预计算、ID范围查询等技术方案,可以显著提升查询效率。特别是在阿里等大型互联网架构中,针对随机查询的优化已成为数据库规范的重要组成部分。本文通过实测数据对比,展示了如何将随机查询性能提升3个数量级,并提供了分库分表环境下的最佳实践方案。
Kubernetes中GPU资源部署与优化实践
Kubernetes · GPU加速 · NVIDIA
GPU加速在深度学习和科学计算中扮演着关键角色,而Kubernetes作为容器编排的事实标准,为GPU资源管理提供了高效解决方案。通过Kubernetes的细粒度资源分配和环境隔离机制,可以显著提升GPU利用率并降低运维成本。NVIDIA GPU Operator进一步简化了驱动和运行时管理,实现自动化部署。本文详细介绍了从驱动安装到Kubernetes集群配置的全流程,包括硬件要求、驱动安装、Device Plugin部署以及GPU加速应用实战案例。针对生产环境,还提供了多租户隔离方案、资源配额控制和常见故障排查指南,帮助开发者高效利用GPU资源。
C++开发操作系统内核:性能优化与工程实践
C++操作系统开发 · 内核编程 · RAII机制
操作系统开发中,C++凭借其零成本抽象和RAII机制成为系统编程的利器。通过指针直接操作内存、内联汇编嵌入机器指令,C++实现了与硬件的亲密接触。模板元编程在编译期完成类型检查和优化,显著提升性能。RAII机制则优雅地解决了资源管理问题,避免了内存泄漏。这些特性使C++在内存管理、进程调度等核心模块中展现出强大优势。开发时需注意禁用RTTI和异常处理以保持性能,配合LLVM/Clang工具链和QEMU调试器,可以高效构建现代操作系统内核。
虚拟电厂中光热电站的优化调度与协同控制
虚拟电厂 · 光热电站 · 储热系统
虚拟电厂(VPP)作为聚合分布式能源的新型电力系统架构,其核心在于通过先进控制技术实现多元电源的协同优化。光热电站(CSP)凭借储热系统的独特优势,在解决新能源间歇性问题上展现出关键价值。从技术原理看,光热电站通过熔盐储热实现电能时空平移,其可调度性完美契合虚拟电厂对灵活资源的需求。典型应用场景中,光热电站需配合风电、光伏等波动电源,采用多时间尺度调度框架和混合整数规划算法,实现日前市场竞价、日内功率平衡和实时频率调节的三级协同。在实际工程中,储热系统配置、气象预测精度和IEC 61850通信标准成为确保系统性能的关键要素。
AI漫剧技术解析与2026年行业TOP5企业盘点
AI漫剧 · AIGC · 生成对抗网络
AI内容生成技术正在重塑数字娱乐产业,其核心原理是通过深度学习模型实现从文本到视觉内容的自动化创作。在计算机视觉和自然语言处理技术的驱动下,AIGC(人工智能生成内容)已经能够完成角色设计、场景构建甚至剧情创作等复杂任务。这种技术突破不仅提升了内容生产效率,更开创了互动叙事、风格融合等全新创作维度。在漫剧领域,头部企业通过自主研发的生成对抗网络(GAN)和神经渲染技术,实现了98.7%的动作自然度和4K级产能输出。以量子动画工场为代表的专业机构,更建立了包含动态风格迁移、多模态剧本引擎在内的完整技术栈。当前AI漫剧已发展出217种视觉体系支持,在保持72小时/集的工业化产能同时,还能实现用户留存率提升3倍的互动体验。
音频图表数据映射技术:从原理到实践
音频图表 · 数据映射 · Web音频
音频图表(Sonification)是一种将数据通过声音形式呈现的技术,广泛应用于医疗监护、金融监控和科研领域。其核心在于数据映射,即将抽象数字转化为可感知的音频特征,如音高、音长、音色和声相。通过Web音频方案(如Highcharts Sonification模块)或专业音频工具(如Sonic Pi),可以实现高效的数据到音频的转换。这种技术不仅提升了数据感知的维度,还在实时监控和大数据处理中展现出独特优势。例如,在电商大促实时监控中,单图表可承载10万+数据点的实时映射,显著提升了数据处理的效率和用户体验。
Video Depth Anything:超长视频深度估计的时空一致性突破
单目深度估计 · 视频时序一致性 · 3D卷积
单目深度估计是计算机视觉中的基础任务,旨在从单张图像或视频序列中恢复场景的三维结构。传统方法在静态图像上表现良好,但在视频应用中面临时序一致性的挑战。Video Depth Anything创新性地结合时空头部模块和时序深度梯度约束,解决了超长视频深度估计的帧间抖动问题。该技术采用轻量级3D卷积和关键帧推理策略,在保持精度的同时实现实时性能,适用于影视特效、自动驾驶感知等需要稳定深度信息的场景。基于Depth Anything V2的改进架构,模型在DVD测试集上将时域误差降低37%,为视频深度估计提供了新的工程实践方案。
AIGC工具选型指南:千笔与锐智AI全领域对比
AIGC · 人工智能生成内容 · 千笔
人工智能生成内容(AIGC)技术正在重塑内容创作领域,其核心在于通过深度学习模型实现高质量内容生成。从技术原理看,AIGC工具依赖生成对抗网络(GAN)和Transformer架构,在图像生成与文本创作场景展现出强大能力。在工程实践中,工具选型需重点考量生成质量稳定性、跨领域适配能力等关键指标。以千笔和锐智AI为例,前者在图像细节表现和风格模板数量上占优,后者则在文本连贯性和多语言支持上更出色。针对教育、电商等典型应用场景,合理组合不同工具的强项模块可显著提升内容生产效率。当前AIGC技术已实现从8K图像生成到智能文案优化的全流程覆盖,为数字内容创作带来革命性变革。
论文写作工具全攻略:从文献检索到格式调整
论文写作工具 · 文献检索 · LaTeX
学术论文写作是每个学生必经的挑战,尤其在文献检索、格式规范等环节耗时费力。现代技术工具通过自动化处理大幅提升效率,如文献管理工具可自动生成参考文献,LaTeX编辑器能解决排版难题。这些工具基于自然语言处理和机器学习技术,通过结构化处理学术内容,帮助学生聚焦研究本身而非格式细节。典型应用场景包括文献综述的智能生成、数据分析的自动化报告等。本文重点解析Connected Papers的关联图谱、Overleaf的LaTeX模板等实用工具,并分享如何组合使用百度学术、SPSSAU等工具构建高效写作流程。
10款高效论文写作工具推荐与使用指南
论文写作工具 · Zotero · Overleaf
论文写作是学术研究的关键环节,涉及文献检索、内容撰写和格式规范等多个技术维度。现代论文工具通过自动化处理大幅提升效率,其核心技术包括文献管理、智能生成和格式规范等模块。优质工具应确保内容原创性,如内置查重机制;同时实现格式自动化,如自动生成目录和参考文献排版。在工程实践中,Zotero等文献管理工具与Overleaf等写作平台组合使用,可显著优化写作流程。特别对于学术写作新手,合理使用Grammarly等语法检查工具能有效提升论文质量。本文精选10款实用工具,涵盖从文献收集到终稿润色的全流程解决方案,帮助研究者聚焦核心创新点。
电商市场竞争分析:核心维度与实战方法论
电商竞争分析 · 市场集中度 · 波特五力模型
市场竞争分析是企业战略制定的基础环节,通过量化指标和模型工具评估行业竞争态势。核心原理包括市场集中度测算(CR4/HHI指数)、波特五力模型等经典框架,结合用户行为数据和供应链指标形成立体分析。在电商领域,这种分析能有效识别差异化机会、优化价格策略并预测行业趋势。典型应用场景包括市场份额争夺、流量获取创新和用户体验优化。通过SWOT加权分析和竞争情报系统搭建,企业可以构建数据驱动的决策体系,其中电商GMV增长率和用户留存率等关键指标尤为重要。
LeetCode两数之和问题解析与C#实现
两数之和 · LeetCode · 算法
哈希表是计算机科学中重要的数据结构,通过键值对存储实现O(1)时间复杂度的查找操作。在算法优化中,常用空间换时间的策略提升性能,两数之和问题正是这一原理的典型应用。该问题要求在数组中找到两个数使其和等于目标值,暴力解法时间复杂度为O(n²),而使用哈希表可优化至O(n)。这种优化思路广泛应用于金融交易匹配、数据库查询等工程场景。通过C#的Dictionary实现,开发者可以高效解决这类查找问题,同时需要注意处理数值溢出和哈希冲突等边界条件。掌握两数之和算法是学习更复杂问题如三数之和、四数之和的基础。
MySQL性能优化:避免ORDER BY RAND()的陷阱与替代方案
MySQL性能优化 · ORDER BY RAND() · 数据库查询优化
在数据库查询优化中,随机排序是一个常见但容易被误用的功能。ORDER BY RAND()作为MySQL实现随机排序的标准方法,其执行原理涉及全表扫描、为每行生成随机值并进行排序,这种操作无法利用索引,导致时间复杂度达到O(N log N)。对于大数据量表,这会引发严重的性能问题,如CPU使用率飙升和响应延迟。在实际工程应用中,特别是在电商推荐系统、内容随机展示等高频场景,这种性能损耗可能引发系统性风险。阿里等企业已将其列入禁用清单,转而采用主键范围随机法、预先计算随机值等优化方案。理解这些替代方案的技术原理和适用场景,对于构建高性能数据库应用至关重要。
U-Net医学图像分割实战:架构解析与性能优化
U-Net · 医学图像分割 · 编码器-解码器
卷积神经网络在图像分割领域具有核心地位,其中编码器-解码器架构通过多层次特征提取与融合实现像素级预测。U-Net作为该架构的典型代表,其创新的跳跃连接机制能有效结合浅层空间信息与深层语义特征,在医学影像分析等场景展现独特优势。针对实际工程中的特征图尺寸匹配问题,开发者可采用对称填充、特征裁剪或网络深度调整等解决方案。结合Dice损失函数与迁移学习策略,即使在少量医学影像数据下,模型也能获得稳定性能。当前在细胞分割、肿瘤检测等应用中,融合注意力机制的改进U-Net已成为工业界首选方案。
AI数据分析工具如何提升学术论文写作效率
AI数据分析 · 论文写作 · Python
数据分析是现代学术研究的核心能力,Python、R等编程语言为研究者提供了强大的分析工具。通过自动化数据清洗、智能统计方法推荐和可视化生成等技术,AI数据分析工具正在重塑学术工作流程。这类工具基于机器学习算法构建代码知识图谱,能够自动识别数据特征并生成合规的分析代码,显著提升研究效率。在经济学面板数据分析、医学生存分析等场景中,AI工具可减少70%以上的重复劳动时间。结合学术规范知识库和审美优化算法,还能自动生成符合期刊要求的可视化图表。对于面临数据分析挑战的研究者,掌握这些工具将有效提升论文质量与产出速度。
Vue大文件上传插件在能源化工行业的应用实践
Vue插件 · 大文件上传 · 分片上传
大文件上传是Web开发中的常见需求,尤其在能源化工等行业,GB级工艺文件的传输面临网络不稳定、服务器压力大等挑战。基于分片上传和断点续传技术,结合Vue插件化开发,可以构建高可靠的上传解决方案。该方案采用Web Worker管理线程、Resumable.js增强传输控制,并针对工业场景优化了错误处理和进度反馈。在化工企业实践中,这类技术显著提升了CAD图纸等大文件的上传成功率,同时通过模块化设计降低了系统改造成本,是数字化转型中的重要技术支撑。
基于贝叶斯算法的Telegram中文垃圾信息过滤实践
贝叶斯算法 · 垃圾信息过滤 · Telegram机器人
贝叶斯算法作为经典的机器学习方法,通过概率统计实现文本分类,在垃圾信息过滤领域具有独特优势。其核心原理是基于贝叶斯定理计算特征词的条件概率,结合中文分词技术(如结巴分词)和特征工程处理,能有效识别变体垃圾信息。该技术不仅支持增量学习适应新型垃圾信息,还能提供可解释的判定依据。在实际应用中,通过Telegram机器人集成、分级阈值策略和性能优化技巧,显著提升了中文群组的垃圾信息识别准确率(达89%)并降低误杀率。典型应用场景包括社交平台内容审核、即时通讯群组管理等,其中特殊符号过滤和变体归一化等预处理技术对中文环境尤为重要。
已经到底了哦
精选内容
热门内容
最新内容
自动化测试核心概念与实战指南
自动化测试是通过脚本和工具替代人工执行测试用例的技术实践,其核心原理包括测试框架、用例管理和持续集成等组件。从技术价值来看,它能显著提升测试效率并降低人工成本,适用于单元测试、接口测试和UI测试等多层验证场景。在实际工程中,Selenium、Appium等工具配合Page Object模式可以构建健壮的测试框架,而合理的7:2:1测试比例(单元:接口:UI)能优化维护成本。随着AI测试工具和低代码方案的兴起,自动化测试正向着智能化、易用化方向发展,成为DevOps流程中不可或缺的环节。
高并发数字资产追踪系统架构设计与性能优化
在分布式系统架构中,高并发处理能力是核心挑战之一,尤其在金融科技和区块链领域更为突出。通过异步处理流水线、智能批处理等核心技术,可以有效解决数据一致性、计算资源争用和网络IO瓶颈等问题。本文以数字资产追踪系统为例,详细介绍了如何利用消息队列(如Pulsar)、动态批处理算法和三级缓存体系来提升系统性能。其中,AI驱动的异常检测结合图神经网络优化,使得GPU利用率稳定在85%±5%。这些技术方案不仅适用于数字资产追踪,也可为其他高并发场景如实时风控、交易清算等提供参考。
RESTful API设计核心原则与实战优化技巧
RESTful API作为现代分布式系统的标准通信协议,其核心在于遵循REST架构风格的约束条件。通过统一资源标识符(URI)和标准HTTP方法实现资源的增删改查,配合无状态通信和缓存机制提升系统可扩展性。在微服务架构中,规范的API设计能显著提升开发效率,例如HoRain云平台通过RESTful规范使第三方接入效率提升40%。典型应用场景包括移动端数据交互、云服务接口开放等,通过JWT认证、Swagger文档化和Postman测试等工程实践,可构建高性能、易维护的API服务体系。
RESTful API设计原则与HoRain云实践
RESTful API是一种基于HTTP协议的接口设计风格,通过资源导向和统一接口等核心原则,实现系统间高效数据交互。其技术价值在于前后端解耦和标准化通信,特别适合微服务架构和分布式系统开发。在实际应用中,合理的URI设计、HTTP方法规范使用以及JWT认证等安全措施至关重要。以HoRain云平台为例,RESTful API在云存储文件管理、用户认证等场景展现了良好的扩展性和维护性,同时通过分页查询和缓存策略优化了接口性能。掌握这些设计规范能有效提升API的可读性和可用性。
微信小程序民宿预订系统架构设计与性能优化实战
微信小程序开发已成为移动应用的重要方向,其无需安装、即用即走的特性大幅提升用户体验。在技术架构层面,Spring Boot+MyBatis Plus组合凭借高并发处理能力和开发效率优势,成为企业级应用的主流选择。本文以民宿行业数字化为切入点,详细解析如何通过微服务架构、Redis缓存优化、WebSocket实时通信等技术手段,构建高可用的预订系统。特别针对行业痛点,实现了智能房态管理和动态定价引擎,系统上线后订单处理效率提升300%,Redis缓存命中率达92%。这些实践对电商、酒店等需要处理高并发交易的场景具有重要参考价值。
Docker Compose部署GitLab:高效团队协作的DevOps解决方案
容器化技术通过Docker实现环境隔离与资源高效利用,其中Docker Compose作为多容器编排工具,通过YAML文件定义服务拓扑结构,显著简化了复杂应用的部署流程。在DevOps实践中,GitLab作为集代码托管、CI/CD于一体的平台,传统部署需要手动配置多个依赖服务。采用Docker Compose方案可将部署时间从2小时缩短至15分钟,并降低80%维护成本,特别适合中小团队快速搭建GitLab环境。该方案通过容器化实现服务隔离、版本可控和资源高效利用,支持快速部署与弹性扩展,是构建自动化开发流水线的理想选择。
Langchain4j Agent Workflows 实战指南与性能优化
Agent Workflows 是一种通过编排多个AI代理(Agent)完成复杂任务的自动化流程技术。其核心原理在于任务分解、上下文传递和动态决策,相较于传统的单次问答式交互,能够更高效地处理复合型任务。在Java生态中,Langchain4j作为对接大模型能力的重要桥梁,其Agent模块为开发者提供了构建智能工作流的强大工具。通过定义Toolkit、Memory、Orchestrator和Evaluator等核心组件,Langchain4j支持多种工作流模式,包括线性流程、条件分支、并行执行和循环迭代。在实际应用中,如电商评论分析场景,Agent Workflows能够显著提升任务处理效率和质量。本文结合实战经验,深入探讨了Langchain4j Agent Workflows的设计与优化策略,帮助开发者更好地应对大模型响应延迟和上下文丢失等常见性能问题。
Unity对象池技术:优化游戏性能的关键实践
对象池是一种通过复用对象来减少内存分配和垃圾回收开销的优化技术,其核心原理是预先创建并管理一组可重用对象。在游戏开发中,对象池技术能显著提升性能,特别是在需要频繁创建和销毁对象的场景,如子弹发射、特效生成和UI元素管理。通过减少GC触发频率和内存分配压力,对象池技术帮助开发者实现更流畅的游戏体验。本文结合Unity引擎,详细解析了对象池的实现原理、性能优化策略以及如何与Addressable资源系统集成,为游戏开发中的性能瓶颈提供了实用解决方案。
RAG系统索引与检索优化实战指南
在信息检索领域,索引与检索是构建高效系统的两大核心技术。索引作为数据的结构化组织方式,通过向量嵌入、混合索引等技术实现非结构化数据的语义化处理;而检索则是基于查询意图的动态匹配过程,其性能直接影响系统响应质量。现代RAG系统通过结合近似最近邻搜索(ANN)和知识图谱等先进技术,在电商搜索、法律咨询等场景展现出强大优势。特别是在处理医疗问答、多语言检索等复杂需求时,合理的向量维度选择和混合检索策略能显著提升召回率。本文深入解析了PGVector、Elasticsearch等工具在实践中的最佳配置方案,并针对Agentic RAG的上下文管理、飞书知识库接入等实际场景提供避坑指南。
OpenClaw部署方案对比:Mac mini本地与云托管优劣分析
在AI工具部署领域,本地化与云端化是两种主流技术路线。本地部署基于Apple Silicon架构,通过Ollama框架管理开源模型,实现数据不出设备的隐私保护;云端方案则依托容器化技术和商业API,提供弹性计算资源。从技术原理看,本地方案依赖终端算力,响应延迟可控制在200ms内,适合高频交互场景;云端方案则通过分布式架构支持百万级上下文窗口,擅长复杂推理任务。工程实践中,Mac mini方案硬件成本约$1200,后续边际成本趋零;云方案则需持续支付服务器和API费用,月均$70-$138。典型应用上,敏感数据处理推荐本地部署,而需要Claude 3等商业模型能力的场景适合云端方案。OpenClaw作为新兴AI代理工具,其混合部署模式正成为技术趋势,支持根据上下文长度智能路由请求。
已经到底了哦