
 jeremymoo
1. 为什么我们需要LLM算法可视化工具?
当我第一次接触Transformer架构时,面对那一堆自注意力机制和位置编码的数学公式,感觉就像在看天书。直到有一天,我在GitHub上发现了一个可以交互式调整参数的Transformer可视化工具,那些抽象的概念突然变得清晰可见。这种"啊哈时刻"正是可视化工具最大的价值所在。
大语言模型(LLM)的核心是Transformer架构,而Transformer最难理解的部分莫过于自注意力机制。传统的学习方式是通过数学公式和静态图示,但这对于理解query、key、value之间的动态关系帮助有限。可视化工具让我们能够:
- 实时观察输入序列如何通过注意力头分配权重
- 直观比较不同头关注的内容差异
- 调整温度参数(temperature)观察softmax分布变化
- 可视化位置编码对语义理解的影响
提示:优秀的LLM可视化工具应该支持从tokenization到输出的全流程展示,而不仅仅是注意力机制部分。
需要模型API调用? 免费领10W Token,多模型网关一键接入 Claude、DeepSeek 等主流模型。
2. Transformer架构的可视化拆解
2.1 自注意力机制的可视化实现
一个完整的自注意力可视化通常包含三个核心视图:
- 权重热力图:展示输入token之间的注意力强度,用颜色深浅表示权重值
- 向量空间投影:将query/key/value向量投影到2D空间,观察它们的分布关系
- 头视图对比:并列显示不同注意力头的关注模式差异
python复制# 简化的注意力权重计算代码示例
def scaled_dot_product_attention(Q, K, V, mask=None):
    matmul_qk = tf.matmul(Q, K, transpose_b=True)  # QK^T
    dk = tf.cast(tf.shape(K)[-1], tf.float32)
    scaled_attention_logits = matmul_qk / tf.math.sqrt(dk)

    if mask is not None:  # 应用mask(如解码器)
        scaled_attention_logits += (mask * -1e9)

    attention_weights = tf.nn.softmax(scaled_attention_logits, axis=-1)
    output = tf.matmul(attention_weights, V)
    return output, attention_weights
2.2 位置编码的可视化探索
Transformer没有RNN的时序结构,全靠位置编码注入序列顺序信息。好的可视化工具应该允许:
- 对比正弦波和可学习位置编码的效果差异
- 观察长序列中相对位置编码的衰减模式
- 调整最大序列长度看位置编码如何扩展
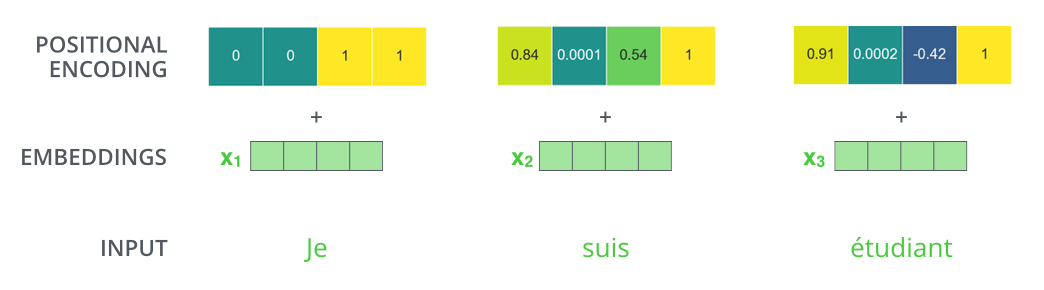
(示例:正弦位置编码的可视化,不同颜色代表不同维度)
2.3 前馈网络(FFN)的维度变换
FFN层通常被忽视,但它实际完成了重要的特征变换:
- 输入维度扩展(通常放大4倍)
- ReLU非线性激活
- 投影回原维度
可视化工具可以展示:
- 各层神经元激活强度的分布变化
- 不同位置token经过FFN后的向量空间移动轨迹
- 残差连接对梯度传播的影响
3. 主流LLM可视化工具对比
| 工具名称 | 交互方式 | 支持模型 | 特色功能 | 适合场景 |
|---|---|---|---|---|
| BertViz | Jupyter插件 | BERT/GPT | 注意力头动态追踪 | 研究分析 |
| ExBERT | Web界面 | BERT系列 | 语义角色高亮 | 教学演示 |
| Transformer Debugger | 命令行 | 自定义模型 | 梯度流动可视化 | 模型开发 |
| LLM Visualization | 本地GUI | GPT类模型 | 全流程管道展示 | 入门学习 |
注意:选择工具时要考虑与目标模型的兼容性。比如专门为BERT设计的工具可能无法正确解析GPT的自回归特性。
4. 构建自定义可视化工具的实践
4.1 基础架构设计
一个可扩展的可视化系统应该包含:
- 模型接口层:通过HuggingFace接口或自定义加载模型
- 数据管道:处理输入文本→token→模型输入的全流程
- 可视化引擎:基于Plotly/D3.js等库实现动态渲染
- 交互控制器:参数调节和视图切换的UI组件
javascript复制// 前端交互示例(基于React)
function AttentionHeadView({ weights }) {
  const [temperature, setTemperature] = useState(1.0);
  const softmax = weights.map(w => Math.exp(w/temperature));

  return (
    <div>
      <input type="range" min="0.1" max="10" onChange={e => setTemperature(e.target.value)} />
      <Heatmap data={softmax} />
    </div>
  );
}
4.2 关键技术实现细节
-
实时反向传播可视化:
- 使用PyTorch的hook机制捕获梯度
- 将张量数据降维后传递给前端
- 用颜色动画展示权重更新过程
-
多头注意力聚合视图:
- 计算各头的平均注意力距离
- 使用t-SNE对注意力模式进行聚类
- 通过雷达图展示头之间的差异性
-
上下文窗口动态加载:
- 对长文本采用滑动窗口策略
- 预计算所有窗口的注意力结果
- 实现无缝滚动浏览体验
4.3 性能优化技巧
- 增量渲染:对超过1000个token的输入,先渲染概要视图,点击后再加载细节
- WebWorker:将繁重的张量计算放在后台线程
- 缓存机制:对相同输入的中间结果进行缓存
- 量化显示:对浮点数只显示3位有效数字
5. 教学场景中的创新应用
5.1 理解模型局限性的可视化案例
通过对比人类标注和模型注意力,可以直观展示LLM的常见问题:
- 指代消解失败:注意力分散在错误的先行词上
- 长距离依赖丢失:随着token距离增加,注意力权重衰减异常
- 常识理解偏差:对隐含常识的关注度不足
5.2 可视化辅助的提示工程
演示不同提示策略对注意力分布的影响:
- Few-shot提示:观察示例如何引导模型关注模式
- 思维链(CoT):跟踪推理过程中的关键token
- 指令微调:对比基础模型和指令模型的关注差异
5.3 安全性与可解释性分析
可视化工具可以帮助识别:
- 偏见放大:某些敏感词是否获得异常关注
- 对抗攻击:对抗样本如何扭曲注意力分布
- 知识边界:模型对未知概念的注意力模式特征
我在实际教学中发现,当学生能够亲手调整参数并立即看到效果时,他们对dropout率、层归一化位置等抽象概念的理解速度会提升3-5倍。特别是在展示为什么transformer需要多头注意力时,动态对比单头与多头的差异比任何口头解释都更有效。