
 记录生活的蛋黄派
1. Dataiku DSS Flow 核心概念解析
在数据科学项目中,可视化工作流是提升团队协作效率的关键。Dataiku DSS(Data Science Studio)中的Flow功能正是为此而生,它通过直观的图形化界面展示数据从原始状态到最终输出的完整旅程。
1.1 Flow的本质与价值
Flow本质上是一个有向无环图(DAG),其中节点代表数据处理步骤(如数据集、Recipe、模型等),边表示数据流向。这种可视化呈现方式解决了传统脚本开发中常见的三个痛点:
- 依赖关系不透明:新手难以理解复杂的代码调用链
- 变更影响不明确:修改某环节时无法直观看到影响范围
- 协作沟通成本高:团队成员对流程理解不一致
实际案例:某零售企业通过Flow将原本需要2周交接时间的预测模型开发流程,缩短到3天即可完成团队轮换。关键在于Flow清晰地展示了特征工程、模型训练、预测输出三个主分区及其内部15个处理步骤的关联关系。
1.2 Flow的核心组件
一个标准的Dataiku Flow包含以下元素类型:
| 组件类型 | 图标示例 | 功能说明 | 典型操作 |
|---|---|---|---|
| 数据集 |  |
存储结构化/非结构化数据 | 预览、采样、统计分析 |
| Recipe | 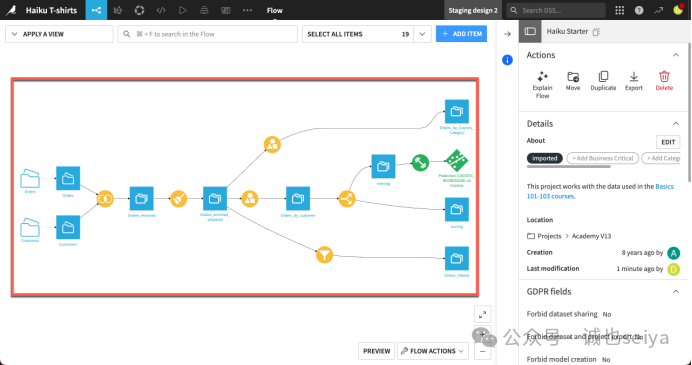 |
数据处理逻辑单元 | Python/SQL/可视化配方 |
| 模型 |  |
机器学习模型节点 | 训练、评估、部署 |
| 代理 | 齿轮图标 | 执行环境配置 | 资源分配、运行监控 |
提示:在Dataiku 11.0+版本中,新增了自定义组件功能,用户可以将常用节点组合保存为可复用的复合组件